In einer Welt des ständigen Wandels und kontinuierlicher Innovation bieten Hackathons eine außergewöhnliche Gelegenheit, Fähigkeiten unter Beweis zu stellen, mit Kolleginnen und Kollegen zusammenzuarbeiten und etwas Neues und Innovatives zu entwickeln.
Kürzlich hatten wir das Privileg, am ShipIT teilzunehmen – einem 24-Stunden-Hackathon bei Accesa, der sich dieses Mal auf die Entwicklung interner Lösungen konzentrierte, die die Möglichkeiten generativer KI nutzen. Das Ziel unseres Teams war es, einen Chatbot zu entwickeln, der das Wissen im gesamten Unternehmen zentral bündelt und mithilfe einer Technik namens Retrieval-Augmented Generation (RAG) sowie der OpenAI API relevante Informationen zu allen unternehmensinternen Fragen bei Accesa bereitstellt.
Doch beginnen wir von vorne. Aus unserer täglichen Arbeit und den Gesprächen mit Kolleginnen und Kollegen wissen wir, dass die Suche nach relevanten Dokumenten und Informationen innerhalb des Unternehmens häufig mit erheblichem Aufwand verbunden ist. Um dieses Problem zu lösen, haben wir eine Lösung entwickelt, mit der Mitarbeitende Informationen aus den Unternehmensrichtlinien einfach per Chat abfragen können.
Nehmen wir beispielsweise an, Sie möchten wissen, ob Sie Ihren Hund mit zur Arbeit bringen dürfen. Diese Information existiert mit Sicherheit irgendwo – sie zu finden würde jedoch entweder viel Zeit in Anspruch nehmen oder eine Nachricht an eine Kollegin oder einen Kollegen erfordern, von der oder dem Sie möglicherweise noch nicht einmal wissen, dass sie oder er die Antwort kennt. Dasselbe gilt für Fragen zu bestimmten Prozessen und deren einzelnen Schritten, für Informationen, die tief in Unternehmensrichtlinien verborgen sind, oder für die Frage, mit wem ein bestimmtes Thema abgestimmt werden sollte. All diese Informationen sind vorhanden – man muss nur wissen, wo man sie findet. Mit einem Chatbot lassen sich relevante Informationen deutlich schneller abrufen, insbesondere wenn dieser die zugrunde liegenden Dokumente als Quellen referenzieren kann.
Im Folgenden geben wir zunächst einen kurzen Überblick über die Architektur unserer Lösung. Anschließend werfen wir einen detaillierteren Blick auf die im Projekt eingesetzten Frontend- und Backend-Technologien und erläutern, wie sie zu einer effizienten und benutzerfreundlichen Lösung beigetragen haben. Abschließend berichten wir von unseren Erfahrungen beim Hackathon und ziehen ein Fazit zum Erfolg unserer Lösung.
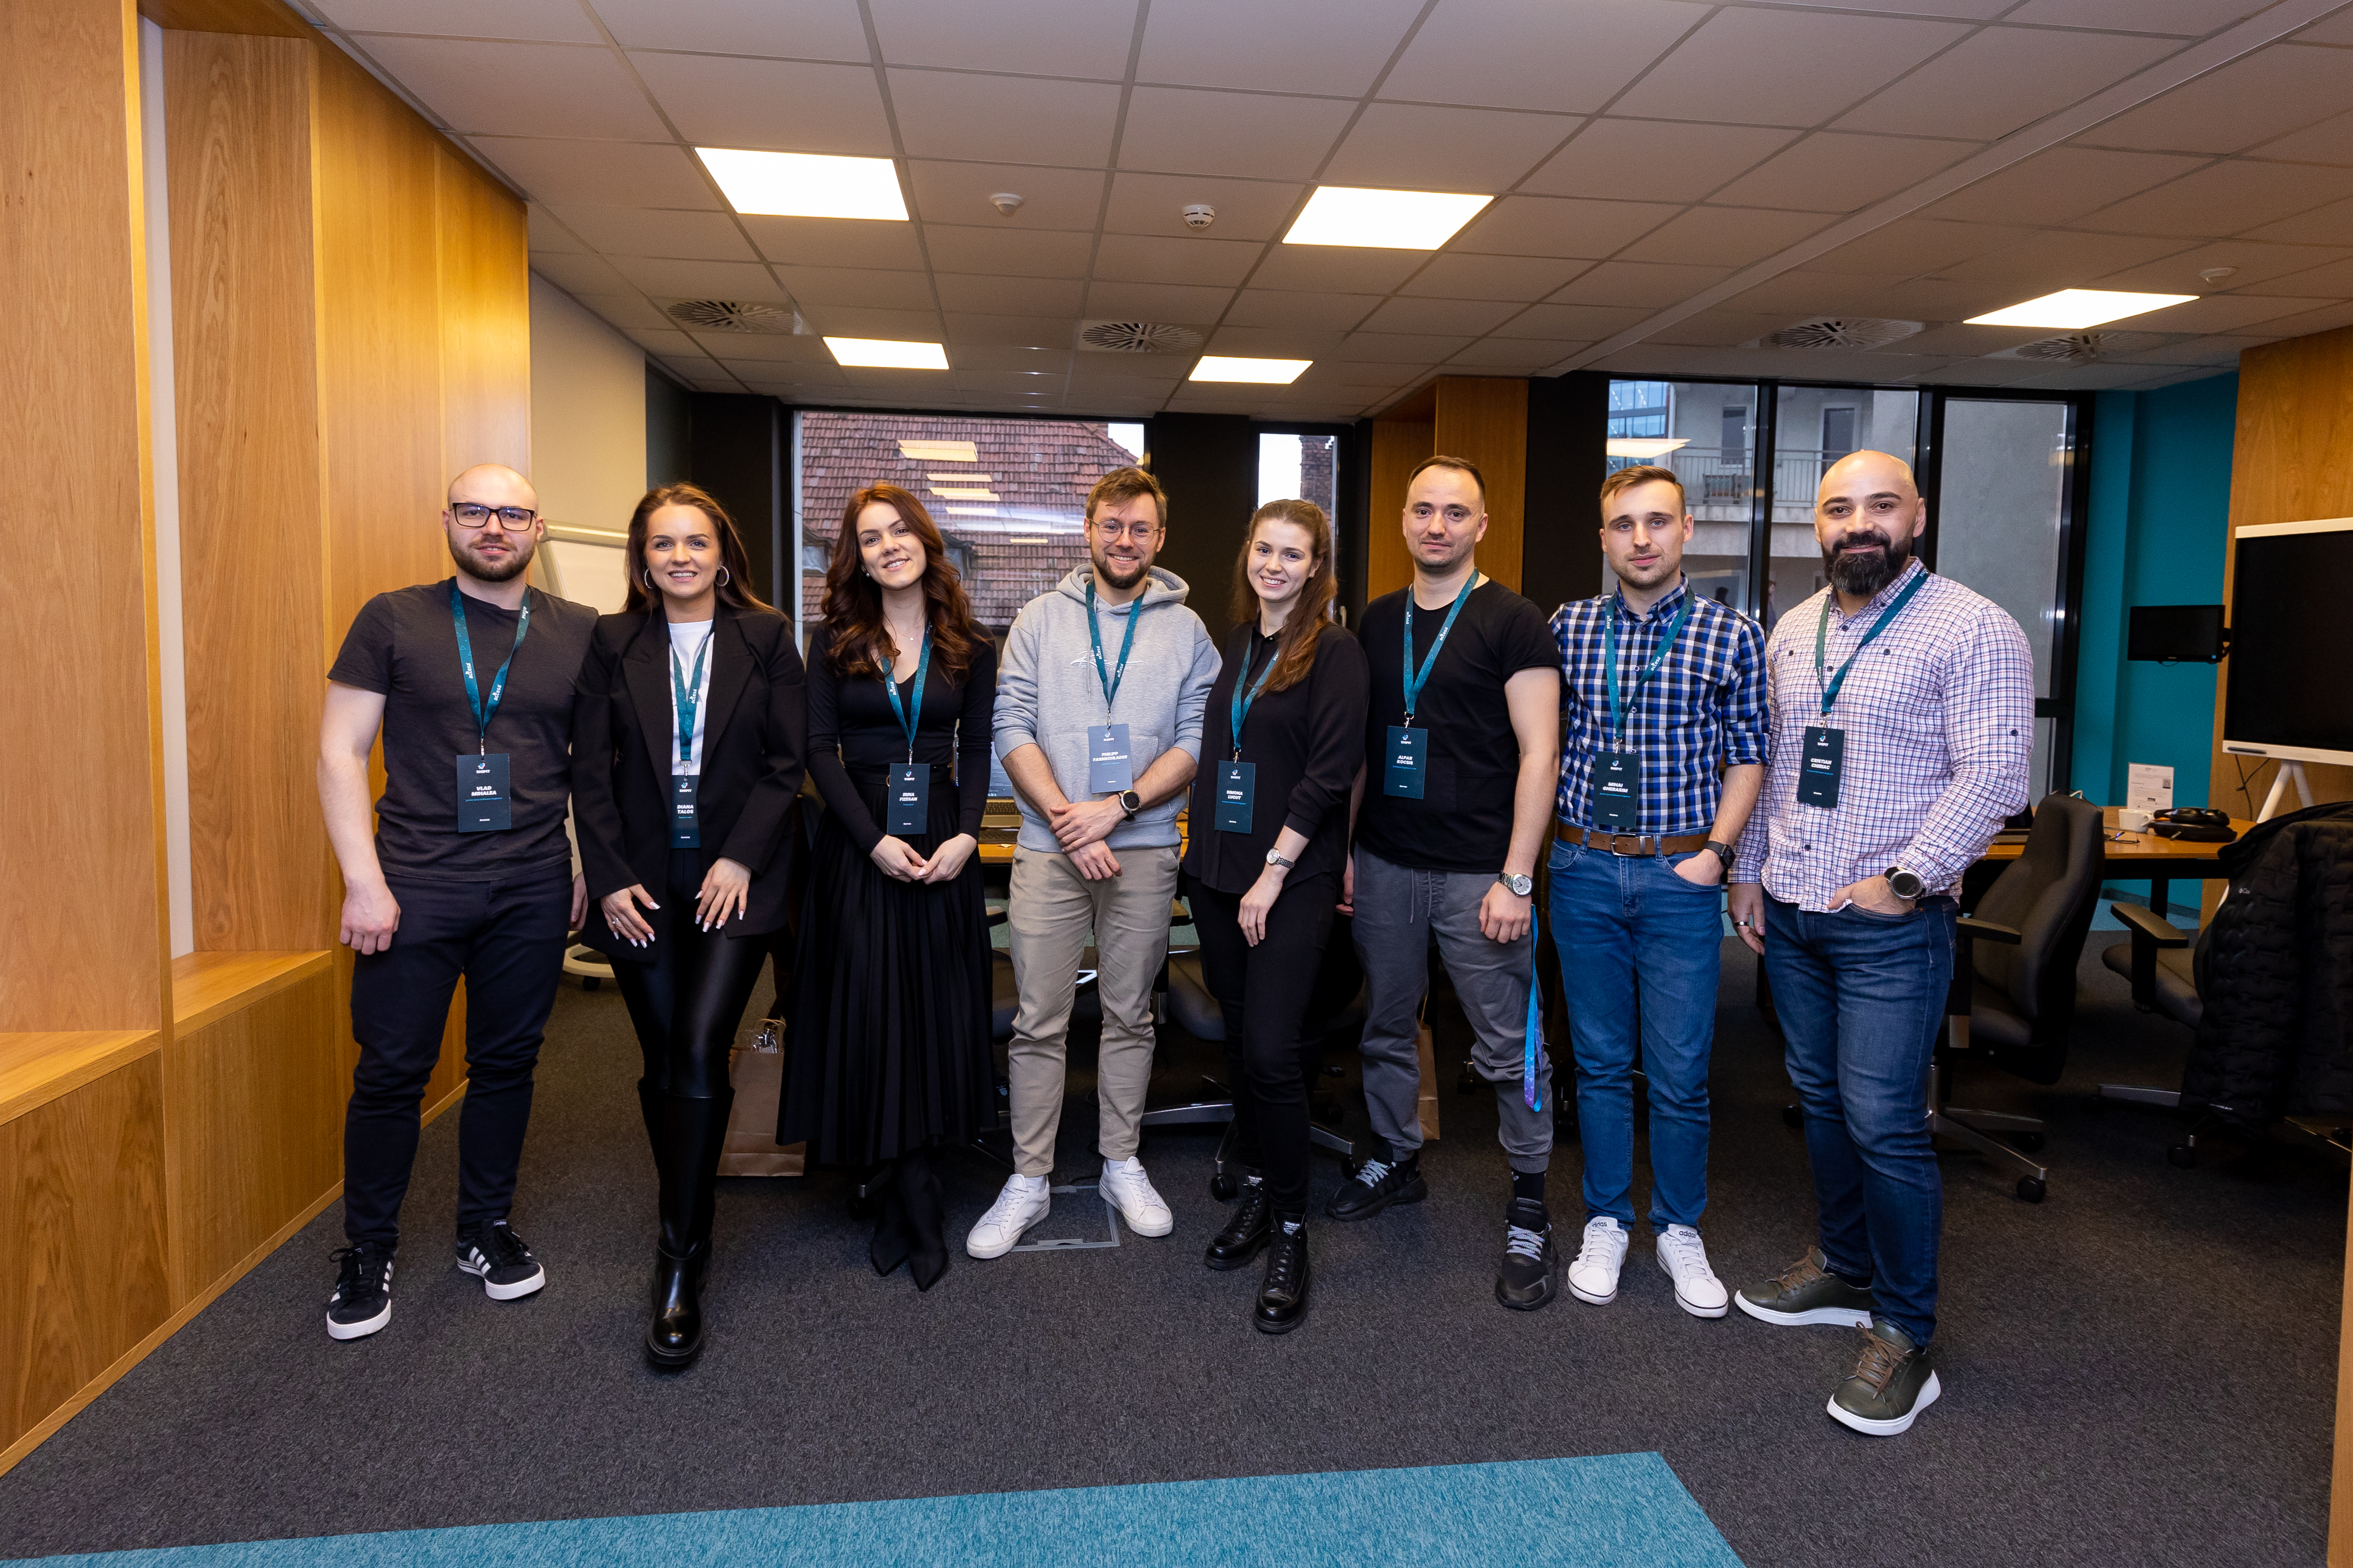
Accesa GPT 1.1-Team; von links nach rechts: Vlad Mihalea, Diana Taloș, Irina Fizeșan, Philipp Farnschlader, Simona Lucuț, Alpar Kocsis, Mihai Gherasim, Cristian Chiriac
Architekturüberblick
Um unsere Ziele zu erreichen, entschieden wir uns für den Einsatz einer generativen KI-Technik namens Retrieval-Augmented Generation (RAG). Im Kern ermöglichen RAG-Systeme, einem Large Language Model (LLM) neues Wissen bereitzustellen, ohne es neu trainieren oder feinabstimmen zu müssen. Anstatt Änderungen am LLM selbst vorzunehmen, besteht die Idee darin, dem Modell relevanten Kontext bereitzustellen, der die Informationen enthält, die es benötigt, um eine passende Antwort zu formulieren.
Die Abbildung zeigt die Architektur der Anwendung. Der Nutzerfluss beginnt im Frontend – einer einfachen Chat-Oberfläche im Material Design, die an das Design der unternehmensinternen Kommunikationsplattform angepasst wurde. Gibt ein Benutzer im Frontend eine Frage ein, wird diese an ein in Python entwickeltes Backend weitergeleitet.
Das Backend prüft zunächst, ob es sich um die erste Anfrage handelt oder ob bereits eine vorherige Interaktion stattgefunden hat, damit der Gesprächsverlauf berücksichtigt und der Kontext der Unterhaltung erhalten bleibt. Anschließend wird die Benutzeranfrage genutzt, um in einer Vektordatenbank auf Basis semantischer Ähnlichkeit nach vorhandenem Wissen zu suchen.
Werden relevante Informationen gefunden, werden die Benutzeranfrage, der bisherige Chatverlauf sowie die ermittelten Wissensinhalte gemeinsam an das Large Language Model (GPT-4) übergeben. Die vom Modell generierte Antwort wird anschließend an das Frontend zurückgesendet und dort in einer chatähnlichen Oberfläche dargestellt.
Im Folgenden gehen wir detaillierter darauf ein, was dabei aus technischer Sicht geschieht und warum wir uns für diesen Technologie-Stack entschieden haben.
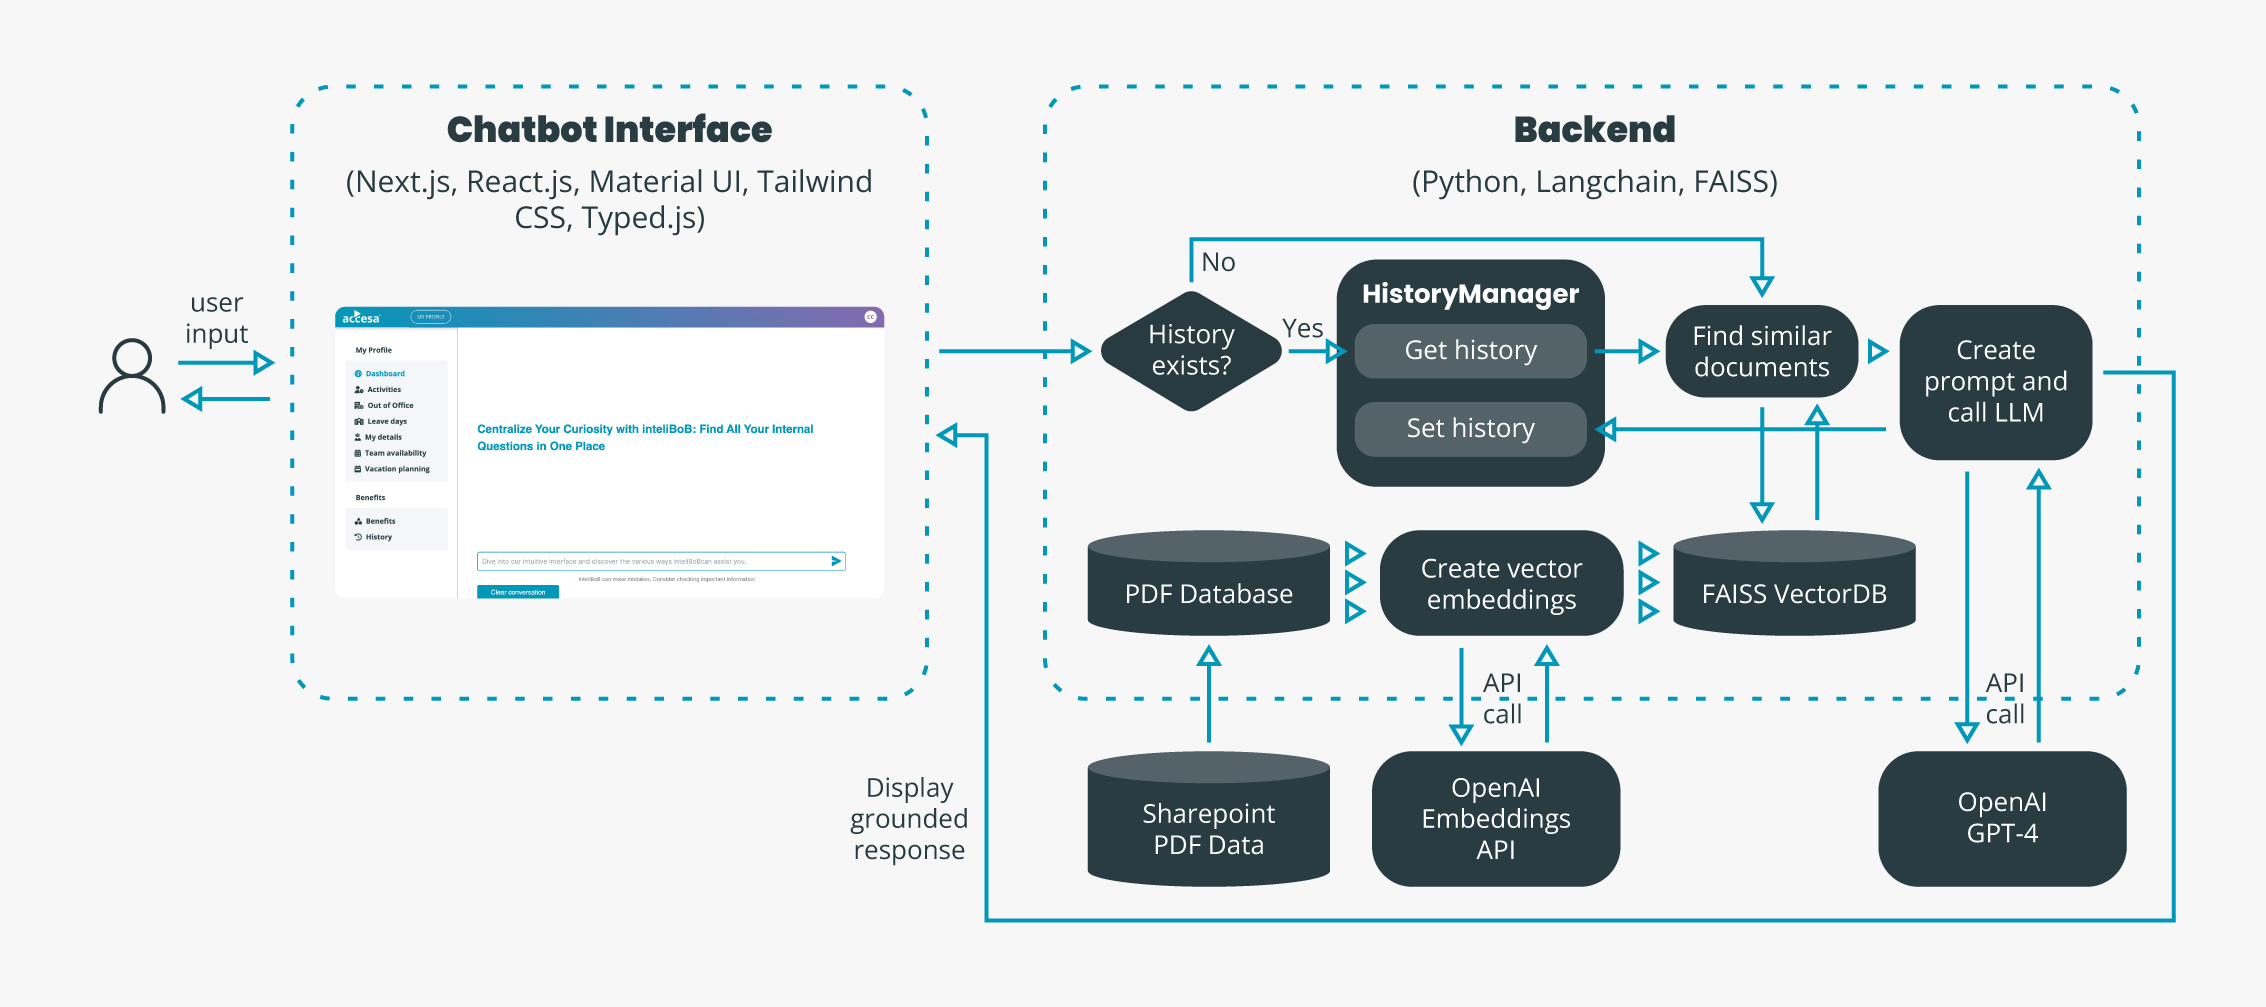
Erstellt von den Autoren: Architekturüberblick des KI-Chatbots
Chatbot-Benutzeroberfläche
Bei der Entwicklung einer effizienten Anwendung, die den Anforderungen der Nutzer gerecht wird, haben wir uns für UI-Technologien entschieden, die eine hervorragende Benutzererfahrung bieten. Im Mittelpunkt standen dabei Einfachheit, ein vertrautes Design sowie die Wiederverwendbarkeit im Hinblick auf mögliche Funktionserweiterungen zu einem späteren Zeitpunkt.
Unsere erste Wahl fiel auf Next.js, das für seine leistungsstarken Funktionen im Bereich Server-Side Rendering (SSR) und Static Site Generation (SSG) bekannt ist. Mit seinen umfangreichen Möglichkeiten bildet Next.js eine solide Grundlage für die Entwicklung leistungsfähiger Webanwendungen.
In Kombination mit React, dem führenden Framework für Benutzeroberflächen, konnten wir wiederverwendbare Komponenten entwickeln und so eine intuitive User Journey schaffen.
Um das Design unseres Chatbots nahtlos in die unternehmensinterne Kommunikationslandschaft zu integrieren, entschieden wir uns für Material UI. Die umfangreiche Sammlung vorgefertigter Komponenten sowie die einfache Anpassbarkeit ermöglichten es uns, das Erscheinungsbild an die bestehende Tool-Landschaft unseres Unternehmens anzupassen.
Für das Styling setzten wir Tailwind CSS ein – ein flexibles CSS-Framework, das unserer Anwendung eine individuelle visuelle Identität verleiht. Mithilfe der vordefinierten Utility-Klassen konnten wir schnell und effizient ein ansprechendes Design umsetzen.
Um die Benutzerinteraktion zusätzlich zu verbessern, integrierten wir Typed.js in unseren Technologie-Stack. Diese dynamische JavaScript-Bibliothek erzeugt Texteffekte in Echtzeit. Unser Ziel war es, die Kommunikation mit dem Chatbot angenehmer und natürlicher wirken zu lassen, indem der Eindruck entsteht, mit einer echten Person zu interagieren, die jederzeit bereit ist zu helfen.
Chatbot-Backend
Die Entscheidung für Python als primäre Backend-Sprache fiel aufgrund der einfachen Erlernbarkeit und der hervorragenden Unterstützung für die Entwicklung von KI-Anwendungen – insbesondere durch Bibliotheken wie LangChain, die die Integration mit den Large Language Models (LLMs) von OpenAI erheblich vereinfachen. Diese Wahl war entscheidend für die Entwicklung einer KI-gestützten Anwendung, die unternehmensspezifische Informationen aus internen Dokumenten extrahieren und nutzen kann.
Um die Antworten der KI auf den unternehmensspezifischen Fakten und Daten von Accesa zu basieren, bestand der erste Schritt darin, eine Pipeline zu entwickeln, die reale Dokumente verarbeitet und in ein nutzbares Format überführt. Als Ausgangspunkt verwendeten wir Dokumente aus SharePoint, die wir zum Nachweis des Konzepts zunächst im Backend speicherten. Ein nächster Ausbauschritt wäre die direkte Integration von SharePoint, um auf sämtliche dort verfügbaren Daten zugreifen zu können.
Diese Dokumente wurden analysiert und in Textabschnitte fester Länge mit einer gewissen Überlappung aufgeteilt, um den semantischen Zusammenhang zwischen den einzelnen Abschnitten zu erhalten. Jeder Abschnitt wurde zusätzlich mit dem Namen des Dokuments sowie der URL seines ursprünglichen Speicherorts versehen. Dadurch lässt sich später nachvollziehen, aus welcher Quelle die vom LLM verwendeten Informationen stammen.
Anschließend werden diese Textabschnitte mithilfe der Embeddings API von OpenAI in Vektoren umgewandelt. Dabei wird die Bedeutung eines Textabschnitts in einen hochdimensionalen numerischen Vektor kodiert. Diese Vektoren werden anschließend in einer Vektordatenbank gespeichert. Hierfür nutzten wir den Open-Source-Vektorspeicher FAISS von Meta.
Die Vektordatenbank enthält somit alle Vektoren sämtlicher Dokumentabschnitte und ermöglicht deren semantische Suche auf Basis von Ähnlichkeiten.
Stellt ein Benutzer über das Frontend eine Frage, wird diese im Backend empfangen und ebenfalls mithilfe der OpenAI Embeddings API in einen Vektor umgewandelt. Anschließend vergleicht FAISS diesen Vektor mithilfe der integrierten Kosinus-Ähnlichkeit (Cosine Similarity) mit allen in der Vektordatenbank gespeicherten Vektoren.
Das Ziel dieses Verfahrens besteht darin, genau diejenigen Dokumentabschnitte zu identifizieren, die der Benutzeranfrage semantisch am stärksten entsprechen. Sind die Vektoren ausreichend ähnlich, werden die entsprechenden Textabschnitte dem Large Language Model als zusätzlicher Kontext übergeben.
Zusätzlich zum Kontext und zur Benutzeranfrage enthält der Prompt auch eine Systemnachricht, die eine entscheidende Rolle bei der Steuerung der Antworten des Large Language Models spielt. Sie gibt dem Modell vor, wie es antworten, sein Ausgabeformat gestalten und sich ausdrücklich auf den bereitgestellten Kontext stützen soll. Das Formulieren dieser Systemnachricht – auch Prompt Engineering genannt – erwies sich als ein zentraler Erfolgsfaktor. Das Team stellte dabei fest, dass zu restriktive Anweisungen die Fähigkeit des LLM beeinträchtigen können, sinnvolle Antworten zu generieren.
Die Systemnachricht enthält außerdem Anweisungen, die verwendeten Quellen aus dem bereitgestellten Kontext in einem definierten JSON-Format zu zitieren. Dadurch kann die Antwort des LLM direkt an das Frontend übergeben werden, das das JSON verarbeitet und die referenzierten PDF-Dokumente entsprechend anzeigt. Um dieses Ausgabeformat zuverlässig zu erreichen, setzten wir eine Technik namens One-Shot Prompting ein. Dabei erhält das LLM ein Beispiel für das gewünschte Ausgabeformat, sodass es dieses korrekt reproduzieren kann.
Diese Vorgehensweise zeigte, dass das LLM sowohl die JSON-Struktur korrekt erzeugen als auch die verwendeten Quellen zuverlässig referenzieren konnte. Allerdings ging dies mit einem höheren Tokenverbrauch einher. Dennoch entschieden wir uns aufgrund der einfachen Implementierung und der zuverlässigen Ergebnisse für diesen Ansatz.
Schließlich ermöglichte die Integration von LangChain die nahtlose Zusammenführung der Benutzeranfrage, des relevanten Kontexts und der Systemnachricht zu einem einzigen Prompt. Die auf dieser Grundlage generierte Antwort des LLM wurde anschließend an das Frontend übermittelt.
Zur Unterstützung fortlaufender Konversationen wird jede Interaktion – bestehend aus der Benutzeranfrage, dem Prompt und der Antwort des LLM – zusätzlich im Backend gespeichert. Dieser Chatverlauf sorgt dafür, dass der Kontext vorheriger Interaktionen erhalten bleibt und ermöglicht dadurch konsistente sowie inhaltlich zusammenhängende Antworten auf Folgefragen.

Der Erfolg einer gemeinsamen Vision
Nach knapp 24 Stunden intensiver Zusammenarbeit präsentierten wir unseren Chatbot erfolgreich in einer Live-Demonstration vor der Jury und zeigten die Funktionsweise unserer Lösung anhand mehrerer Beispielanfragen. Unser System beantwortete die Fragen korrekt und verwies dabei präzise auf die PDF-Dokumente, die als Grundlage für die Antworten dienten.
Darüber hinaus prüften wir, wie der Chatbot auf Eingaben reagiert, die nicht unmittelbar auf dem bereitgestellten Kontext basieren. Auch diese Aufgabe meisterte er erfolgreich. Wenn es einen Aspekt gibt, der noch verbessert werden könnte, dann ist es die Latenz. Für einen produktiven Einsatz sollte daher in Betracht gezogen werden, schnellere Large Language Models lokal zu betreiben, da wir für unseren Prototyp die vergleichsweise langsame GPT-4 API verwendet haben.
Insgesamt war die Hackathon-Erfahrung intensiv, doch das engagierte und bewusste Mitwirken des gesamten Teams machte sie zu einem unvergesslichen Erlebnis. Dazu trug nicht zuletzt die hervorragende Organisation der Veranstaltung bei – mit klar kommunizierten Zielen, Richtlinien, Zeitplänen und Erwartungen. Sowohl innerhalb unseres Teams als auch – soweit wir es wahrnehmen konnten – in allen anderen Teams herrschte eine produktive, motivierte und vor allem begeisterte Atmosphäre.
Das Highlight der Veranstaltung war zweifellos die Abschlusspräsentation aller entwickelten Lösungen. Zu sehen, was unsere Kolleginnen und Kollegen in so kurzer Zeit geschaffen haben und wie sie generative KI für unterschiedlichste Anwendungsfälle eingesetzt haben, war wirklich beeindruckend.
Abschließend möchten wir uns im Namen unseres gesamten Teams herzlich für die Organisation dieses äußerst lehrreichen Hackathons bedanken – für die Möglichkeit, mit modernster Technologie zu arbeiten, sowie bei allen anderen Teams für die beeindruckenden Lösungen, die sie innerhalb dieser kurzen Zeit entwickelt haben.


